Chapter 4-1 CFL & PDA
编译原理笔记
- 发布
- 篇幅
- 2,859 字 · 8 分钟
- 阅读
- – 次
合订本 · Vol.编译原理4 / 11
- 01Chapter 1&2 Intro to Compilers&Tools
- 02Chapter 3-1 Finite Automata
- 03Chapter 3-2 Lexical Analysis
- 04Chapter 4-1 CFL & PDA
- 05编译原理笔记-未命名
- 06编译原理Lab笔记
- 07编译原理复习指北
- 08中端优化:数据流分析
- 09中端优化:符号执行
- 10中端优化:指针分析
- 11后端
PART I: Context-Free Language
CFG: Context Free Grammar
CFG 定义为一个一个一个四元组:
- : 非终结符
non-terminal有限集 - : 终结符
terminal有限集。终结符和非终结符不重合。 - : 作为起点的非终结符,
- : production rules , 是非终结符;, 是某些终结符和非终结符的连接(或者单个符)
CFG 的 Derivation:
Intro
推导 (deviation) 是 CFG 的运算法则,用来从几个 production rules 推导到更多的 CFL.
- 推导方式:
- Assumption:
- Deviation: (可以省略下标 G, 如果语境比较清晰)
- 跳步骤、连续推导的符号:
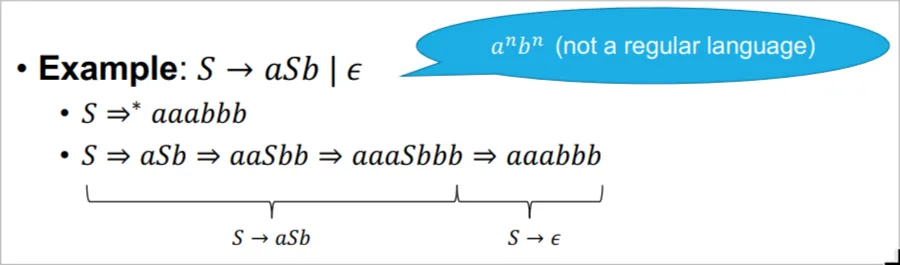
这就是“上下文无关”的体现:assumption 所包含的性质不随这个单元的前面连接的东西 () 或者后面连接的东西 () 的出现与否而改变
CFL: Context Free Language
CFL语言中的词是非终结符的集合,并且都能根据 CFG 的文法推导出来。
Left-Most Deviation
-
最左推导
-
每一步推导都只把左边的 non-terminal 换成 terminal
-
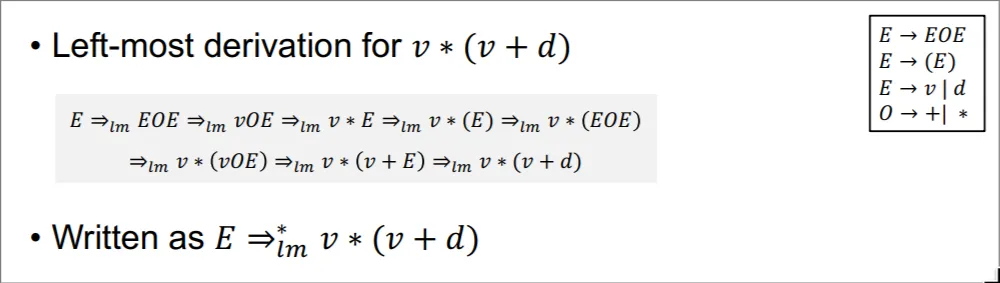
-
最右推导 类似喵
Parse Trees / Syntax Trees 语法树
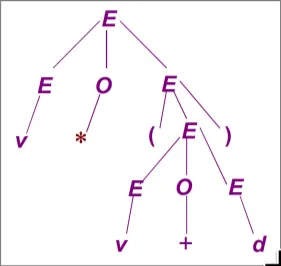
上文中,给定一个终结符串,用最左推导构成的语法树。
- 推导其实是建立语法树的过程。
- 语法树可以通过根据 production rules,从某个非终结符开始,进行一定顺序的推导(如最左/最右推导)构成
- 树中每个叶都是终结符,每个节点都是非终结符。
Ambiguity
- Ambiguity 描述了 CFG 的一种性质:如果 CFG 构成的 CGL 中的一个字符串可以有多个不同的语法树,那么这个 CFG 是有二义性的;如果 CFL 的所有字符串都有唯一树的与之对应,那这个 CFG 就没有二义性。
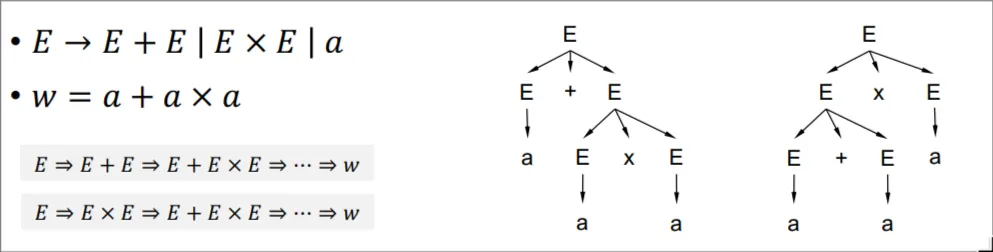
Inherent Ambiguity
- 有些 CFL 只有 ambiguous 的语法,也就是说对于这些语言我们无法消除其二义性。
- 并没有一个明确的算法来判定一个语法是否有二义性!
- 并没有一个公式化的算法来消除所有能消除二义性的 CFL 的二义性!
(try to) Eliminating Ambiguity
有几个尝试消除其二义性的方法
1. Priority&Associativity
提高某些运算符的优先级,先推导它们。
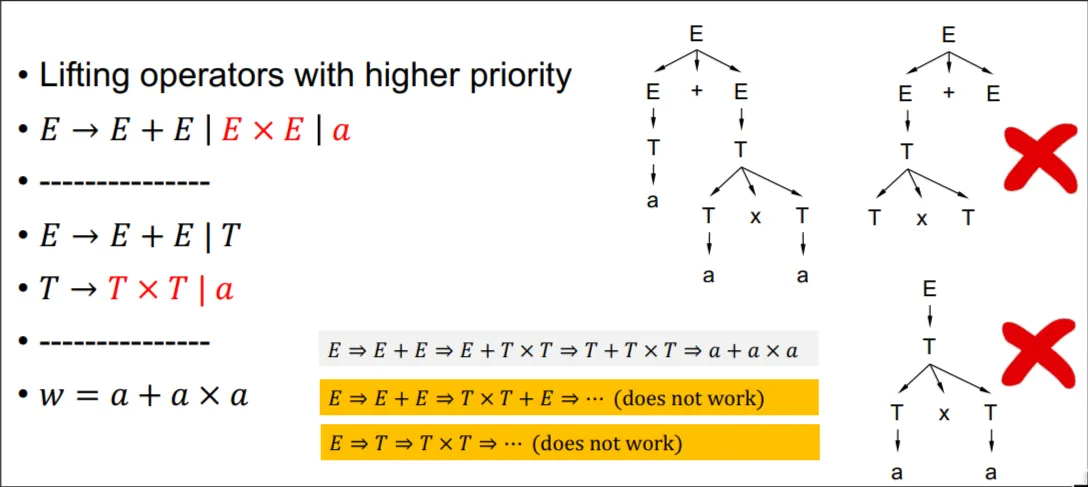
2. 重写文法
比如 if-else 的二义性
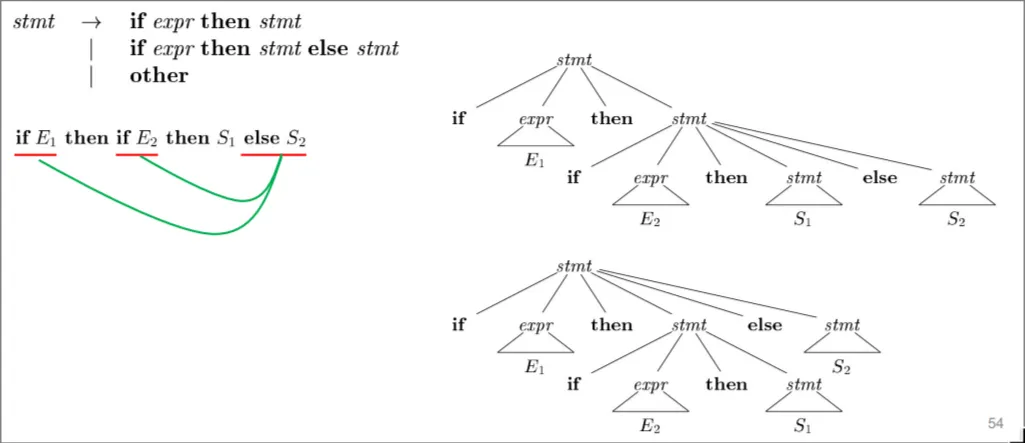
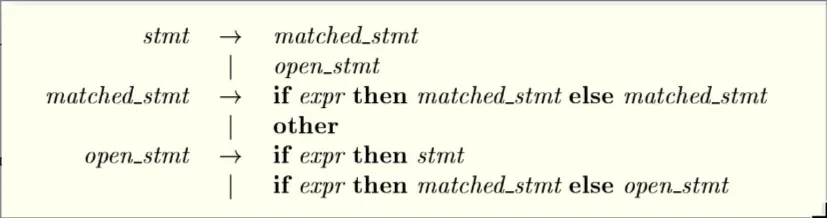
Using Ambiguous Grammar (生肉)
- Given that we cannot always eliminate ambiguity, just use it!
- We will discuss how we use ambiguous grammar in the next Lecture when introducing specific parsing techniques
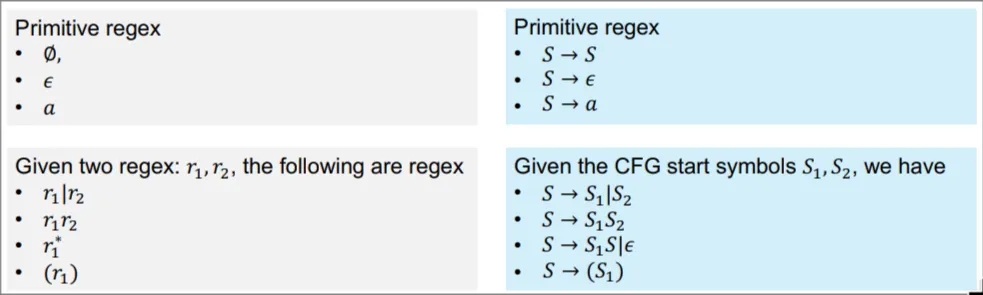
All regular languages are context-free languages.
PART II: Push-Down Automata
Intro
- Regular language = DFA/NFA
- Context-free language = PDA =
AI: PDA(Pushdown Automata,下推自动机)是一种理论计算模型,它扩展了有限自动机(DFA/NFA)的能力,通过引入一个栈(stack)来存储和检索信息。这个名字中的“push-down”(下推)源于其核心操作:在处理输入符号时,PDA 可以将符号推入栈(push)或从栈中弹出符号(pop),从而实现对输入的动态记忆和回溯能力。这种栈结构使得 PDA 能够处理具有嵌套结构或递归性质的语言,例如括号匹配或嵌套的函数调用,而这些是有限自动机无法处理的。下推自动机是研究上下文无关语言(CFG)的重要工具,它在编译原理中用于语法分析阶段,帮助解析程序代码的结构,确保其符合语言的语法规则。
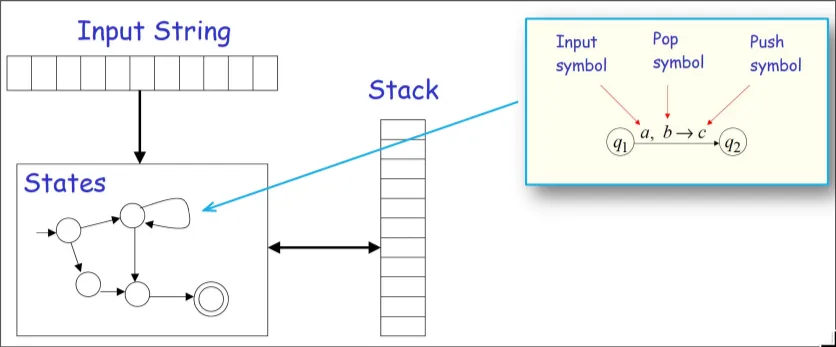
形式化定义:七元组
一个 NPDA/PDA 可以定义为以下形式
- 状态的有限集
- 输入字符串的字母表
- 可以入栈出栈的字母表
- trasition function
- 左边:输入的字符和入栈的字符;
- 右边:到达的状态和目前在栈内的字符 (的连接)。Non-destiministic, 所以是幂集。
- 初始状态
- 栈内的初始字符 (stack start symbol)
- final state 的集合,
Instantaneous Description
Instantaneous Description 是对 PDA 在某个状态的描述:
- : 当前状态
- : 剩余没有进入状态机的输入
- : 栈中剩下的内容
针对一个转换函数:
- 是之前的状态, 是转换函数之后的状态
- 是要出栈的元素, 是入栈的函数
- 是下一步的输入
我们有:
Language of PDA
PDA 既有入栈出栈,又有状态转移,因此有两种角度来定义 language, 并且可以证明二者其实等价。
Acceptance by final states
一个 string 能被 PDA 接受,如果
- 所有的输入都被消耗
- 最终可以停留在一个 final state PDA 定义的语言自然是这些 stirng 的集合:
Acceptance by empty stack
一个 string 能被 PDA 接受,如果
- 所有的输入都被消耗
- 最终栈是空的 PDA 定义的语言自然是这些 stirng 的集合:
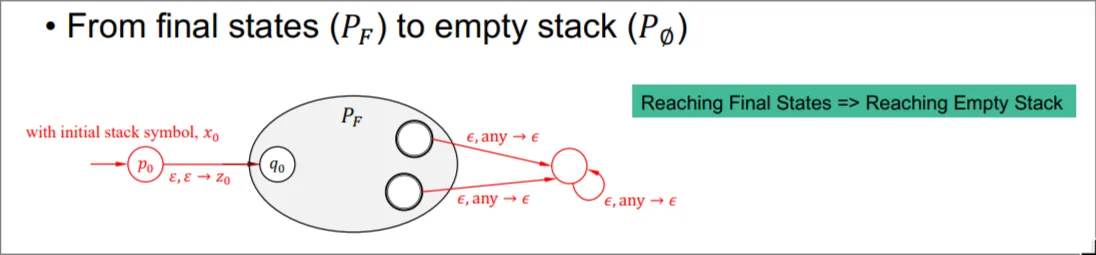
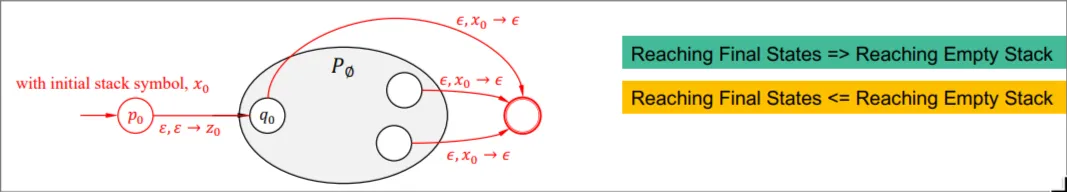
等价?
如果一个语言可以通过某种 PDA 通过最终状态接受,那么也存在另一个 PDA 可以通过空栈接受相同的语言,反之亦然。
PART III: CFG = PDA
1.
如何从 CFG 构造一个 PDA?
对于个 CFG 四元组,我们可以构造一个等价的 PDA 七元组;令这个 PDA:
解析:
- 只有一个状态,并且没有 final state. 也就是说这个 PDA 是 Acceptance by empty stack 的;
- 输入都是终结符,栈中的既可以是终结符也可以是非终结符;
- 初始状态时栈中只有一个作为起点的非终结符。
CFG 的规则如何向 PDA 的规则转化?
对一个目标是空栈的 PDA, 状态不要紧,我们只关注 PDA 栈的变化:从栈顶开始 peek,
- 如果栈中遇到一个非终结符 ,就把他 pop 出来,再入栈 CFG 中的 production rules 规定的推导 中的 :
- 如果遇到一个终结符 ,就直接把他读取并弹出:
2.
如何从一个(可能有点特殊的)PDA 构造 CFG?
我们还是只讨论 Acceptance by empty stack 的 PDA, 为了方便我们忽略最终状态。对任何一个 PDA, 写成 , 我们找到一个 CFG 写作
解析:
- 定义非终结符集合:非终结符不仅包括起点的 non-terminal, 还包含 PDA 中任意一个路径,即把这个路径连同起点终点构造成一个包含了其特征的非终结符,叫做 , 代表从 p 状态转移到 q 状态,弹出 .
- 定义 production rules:
- 对于 PDA 任意一个状态 ,存在 rule: 初始的非终结符 从 到 、弹出 剩下空栈的路径
- 对于一个消耗输入 , 弹出 不压入任何字符的路径,存在 rule:
- 对于一个消耗 , 弹出 并压入 的路径,存在 rule:
例子:
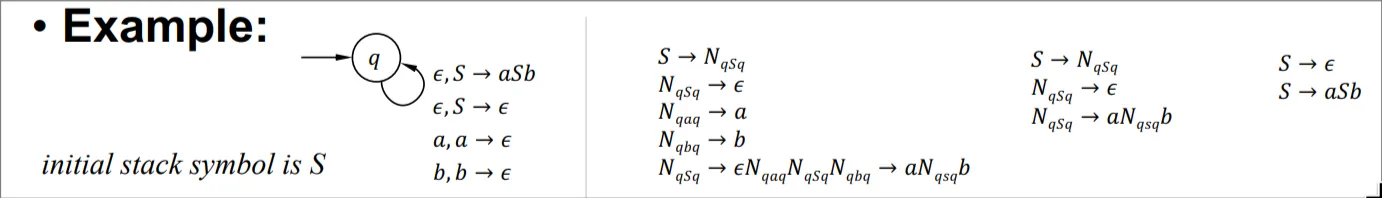
DPDA: Deterministic PDA
在任何时刻,对于给定的输入符号或栈顶符号(这俩任意一个一样都不行),最多只有一个转移动作。
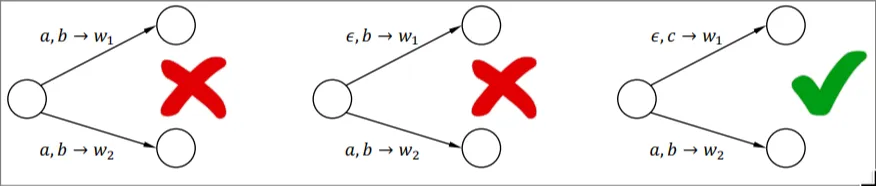
- CFL 一定有 PDA, 但是不一定有 DPDA.
- DPDA 的语言是没有二义性的!
PART IV: Properties of CFL
CLosure Properties
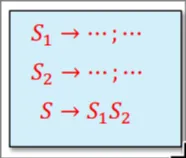
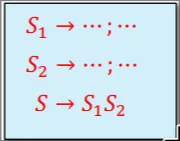
给定两个 CFL 和 (对应的 CFG 起始非终结符分别是 ), 以下的语言也是 CFL:
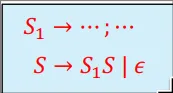
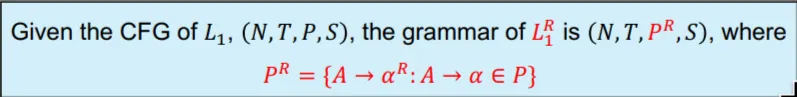
Intersection of CFL
-
- 证明:取 ,则 , 这不显然不是 CFL?
-
- 证明: 如果非一定是 CFL, 那前面的交就一定是了。
-
- 证明:
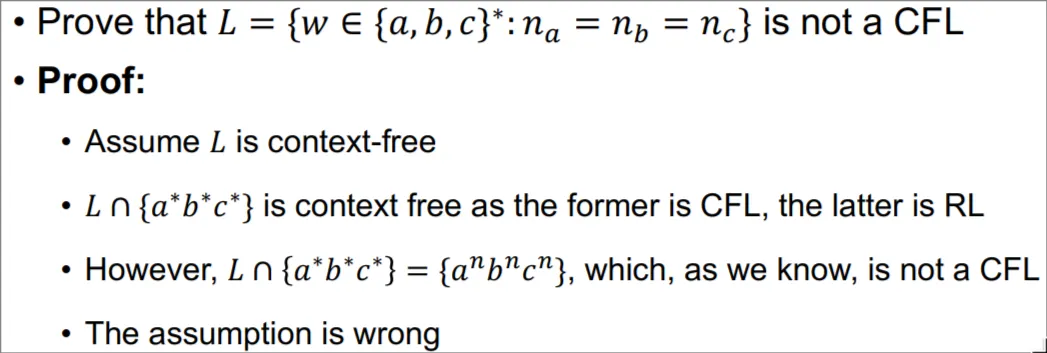
但是一个 CFL 和一个 RL 的交是 CFL: 构建一个模拟 CFL 的 NPDA、一个模拟 RL 的 DFA, 把他们交起来
Application of the Properties
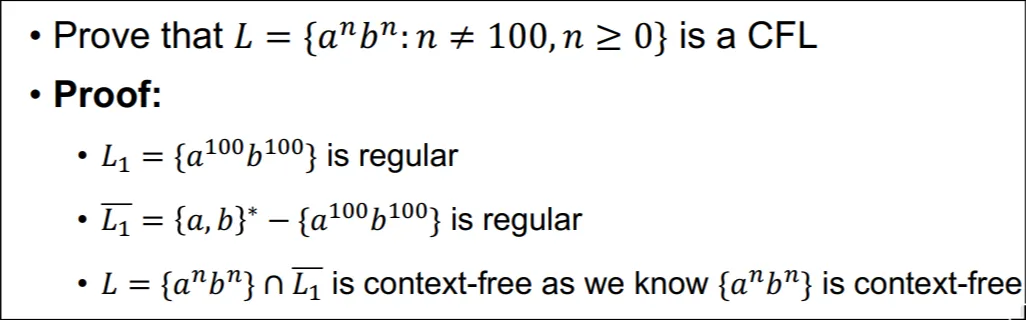
为什么 是 CFL? 因为能把他构造成一个很基础的 PDA.
Decidable Properties
CFG(上下文无关文法)的可判定性质(Decidable Properties)是指可以通过算法来确定其结果的性质。
1. 给定一个 CFG, CFL 是否为空?
检查起始非终结符是否没有被使用,或者无效使用
2. 给定一个 CFG, CFL 是否无限?
算法:
-
移除无用的非终结符:
无用的非终结符是指那些既不能推导出终结符字符串,也不能出现在任何可推导出终结符字符串的产生式中的非终结符。通过移除这些非终结符,可以简化文法,同时不影响其生成的语言。 -
移除单元产生式和空产生式:
单元产生式是指形如 的产生式,其中 和 都是单个非终结符;空产生式是指形如 的产生式。移除这些产生式可以进一步简化文法,同时便于后续分析。 -
构建剩余非终结符的依赖图:
依赖图是一个有向图,其中每个节点代表一个非终结符,边 表示在某个产生式中,非终结符 可以直接或间接推导出非终结符 。通过构建依赖图,可以直观地表示非终结符之间的推导关系。 -
检查依赖图中是否存在环:
如果依赖图中存在环,说明存在至少一个非终结符可以通过自身或一系列非终结符的推导最终回到自身。这种循环结构表明文法可以无限地生成字符串,因此生成的语言是无限的。如果没有环,则生成的语言是有限的。
通过上述步骤,可以判断一个 CFG 生成的语言是否是无限的。
3. 给定一个 CFG, 某个字符串是否属于其 CFL?
- 算法 1:构造 NPDA, 看看 NPDA 能否接受这个 String
- 算法 2:the CYK algorithm (O (n3))
Undecidable Properties
- CFG 是否有二义性
- CFG 是否有不可避免的二义性
- 两个 CFG 的交是否为空
- 两个 CFG 是否等价
- 某个 CFG 是否可以等价为
PART V: Pumping Lemma for CFL
Chomsky Normal Form
一种 CFG 的标准形式。如果 CFG 的所有 production rule 都是如下形式:
- 其中 是终结符, 是非终结符, 是起始非终结符 那么这个 CFG 就是 CNF.
语法树是一个二叉树。
上下文无关语言的泵引理
定义: 泵引理可以用于证明一个语言不是上下文无关语言(CFL)。它指出,如果一个语言是上下文无关的,那么所有足够长的字符串都必须满足某些“可泵性”条件。
泵引理的陈述: 设 是一个上下文无关语言(CFL)。则存在一个常数 (称为泵长度),使得对于任何字符串 ,只要 ,就可以将 分解为 ,满足以下条件:
- (即 和 至少有一个非空)
- (即 的长度不超过 )
- 对于所有 ,字符串 仍然属于 。
解释:
- 条件 1:确保至少有一个部分可以被“泵”(即重复)。
- 条件 2:限制“可泵部分”的长度,使其在某个局部范围内。
- 条件 3:无论“泵”的次数多少,生成的字符串仍然属于语言 。
应用: 泵引理主要用于证明某个语言不是上下文无关的。如果一个语言违反了泵引理的条件,则该语言不是上下文无关语言。
示例: 假设 。假设 是上下文无关的,那么存在一个泵长度 。选择字符串 ,根据泵引理, 可以被分解为 ,满足上述条件。然而,无论怎样分解,都无法保证 仍然属于 (因为 、 和 的数量必须严格相等)。因此, 不是上下文无关语言。
注意:
- 泵引理只能用来证明一个语言不是上下文无关的,不能用来证明一个语言是上下文无关的。
- 对于某些语言,可能需要尝试多个字符串才能找到违反泵引理的反例。